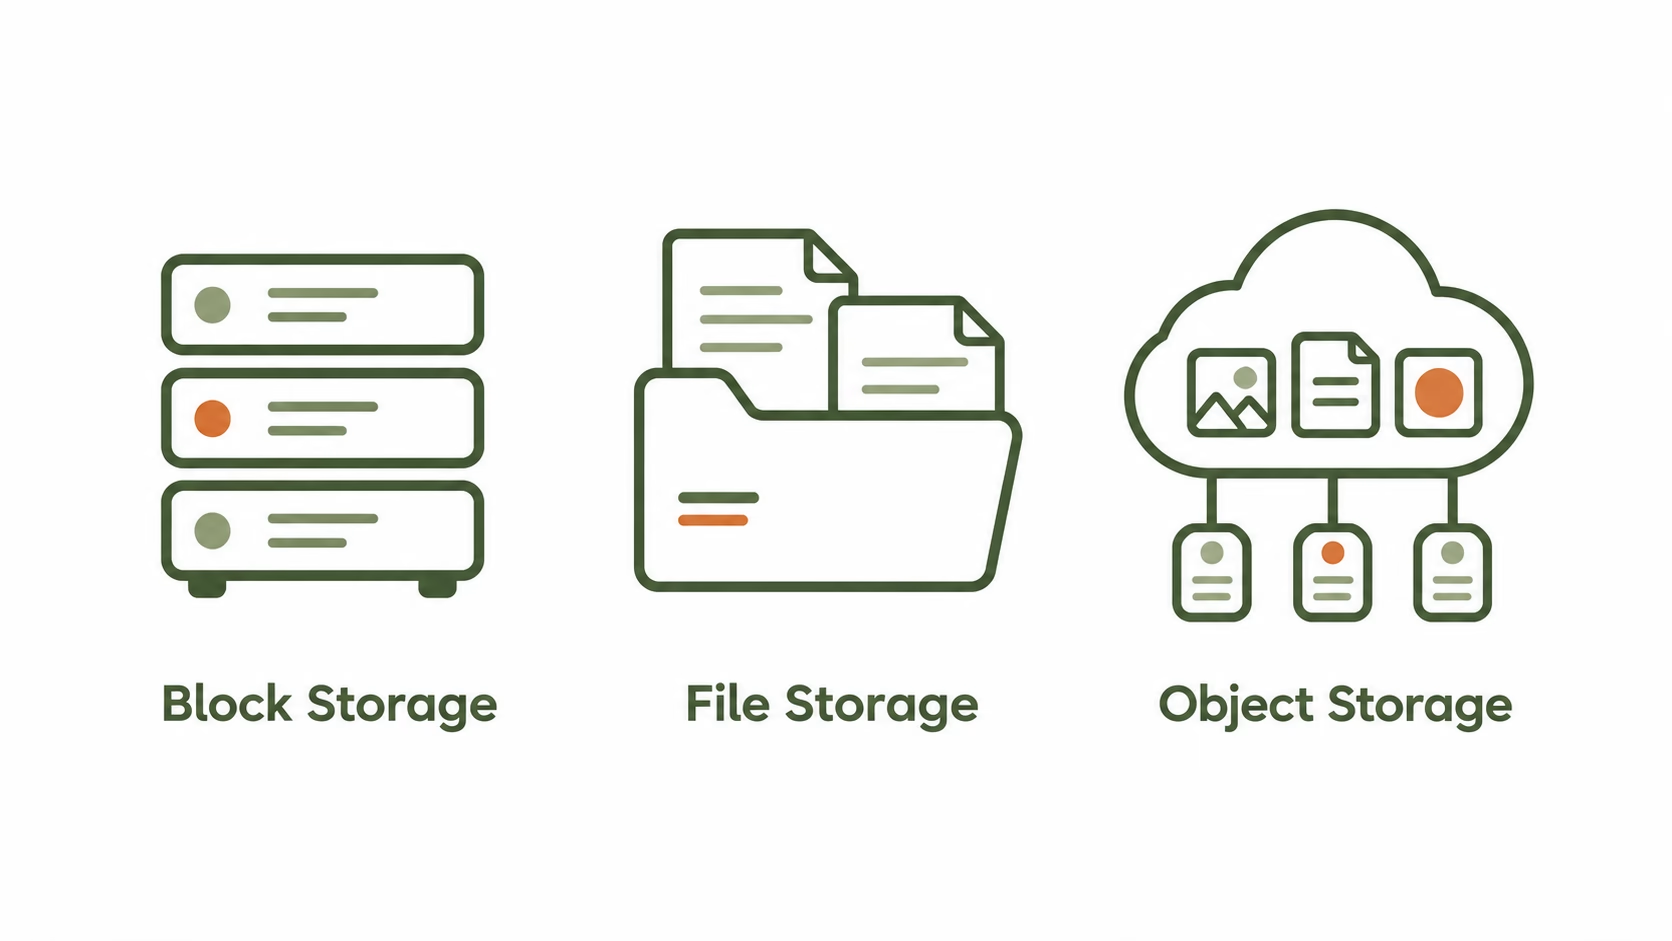
Eine virtuelle Maschine braucht Speicherplatz, ein Team möchte gemeinsam auf Dokumente zugreifen und eine Anwendung muss große Mengen an Bildern ablegen. In allen drei Fällen geht es um Daten – trotzdem sind die Anforderungen unterschiedlich. Genau hier kommen die drei grundlegenden Storage-Typen ins Spiel: Block Storage, File Storage und Object Storage. Sie unterscheiden sich vor allem darin, wie sie Daten organisieren und Anwendungen bereitstellen.
Der wichtigste Gedanke dabei: Storage bezeichnet hier nicht die verwendete Festplatte, sondern die Art des Datenzugriffs. Die Frage lautet also weniger „Welche Hardware speichert meine Daten?“ als vielmehr „Wie möchte meine Anwendung mit diesen Daten arbeiten?“.
Block Storage: Speicher wie eine virtuelle Festplatte
Block Storage stellt Speicher als adressierbare Blöcke bereit. Die darüberliegende Software entscheidet, welche Inhalte in diesen Blöcken liegen und wie daraus nutzbare Daten werden. Für ein Betriebssystem verhält sich ein solches Volume grundsätzlich wie ein Datenträger. Häufig wird darauf ein Dateisystem angelegt; auch Datenbanken können auf dieser Speichergrundlage arbeiten.
Das lässt sich mit einem leeren Grundstück vergleichen: Der Speicher stellt die Fläche bereit, während das Betriebssystem die Struktur darauf errichtet. Der Blockspeicher selbst muss nicht wissen, ob ein bestimmter Bereich zu einem Foto, einer Konfigurationsdatei oder einer Datenbank gehört.
Seine Stärken spielt Block Storage bei Anwendungen aus, die häufig gezielt kleine Datenbereiche lesen und verändern müssen. Typische Einsatzgebiete sind virtuelle Festplatten, Datenbanken und andere transaktionsintensive Anwendungen. Entsprechend wichtig sind hier geringe Zugriffszeiten und eine leistungsfähige Speicheranbindung.
Ein typisches Szenario: Eine Virtualisierungsplattform stellt einer virtuellen Maschine ein Speicher-Volume zur Verfügung. Das Gastbetriebssystem übernimmt anschließend die Organisation seiner Dateien. Block Storage liefert dabei die Speichergrundlage, nicht die fertige gemeinsame Dateiablage.
File Storage: Dateien und Ordner im Mittelpunkt
File Storage arbeitet mit dem vertrauten Prinzip aus Dateien, Verzeichnissen und Pfaden. Statt einzelne Speicherblöcke anzusprechen, öffnen Anwendungen beispielsweise eine Datei unter einem bestimmten Verzeichnispfad. Die Dateisystemebene übernimmt die Organisation der Inhalte.
Bei gemeinsam genutztem Netzwerkspeicher erfolgt dieser Zugriff häufig über NFS oder SMB. Benutzer und Anwendungen erhalten damit eine Dateiablage, ohne die darunterliegenden Speicherblöcke selbst verwalten zu müssen.
Das macht File Storage besonders passend für:
- gemeinsam bearbeitete Dokumente,
- persönliche Benutzerverzeichnisse,
- Projektordner und klassische Netzlaufwerke,
- Anwendungen, die eine gewöhnliche Datei- und Verzeichnisstruktur erwarten.
Ein anschauliches Beispiel ist ein zentraler Dateiserver: Mehrere Rechner greifen auf dieselben Projektordner zu. Für die Benutzer steht nicht das Speicher-Volume im Mittelpunkt, sondern die Frage, wo ihre Dateien liegen und welche Ordner sie öffnen dürfen.
Der entscheidende Unterschied zu Block Storage: Der Server stellt bereits organisierte Dateien bereit, nicht lediglich einen Datenträger, dessen Inhalt der zugreifende Rechner selbst strukturieren muss.
Object Storage: Daten über eine Schnittstelle verwalten
Object Storage speichert Inhalte als Objekte. Ein Objekt besteht aus den eigentlichen Daten, ergänzenden Metadaten und einer eindeutigen Kennung beziehungsweise einem Schlüssel. Der Zugriff erfolgt typischerweise über eine HTTP-basierte API, häufig über eine S3-kompatible Schnittstelle.
Objekte werden dabei häufig in sogenannten Buckets zusammengefasst. Anders als bei einem klassischen Dateisystem steht keine gewöhnliche Verzeichnishierarchie im Mittelpunkt, sondern die Identifikation und der Abruf einzelner Objekte.
Statt eine Bilddatei über ein eingebundenes Netzlaufwerk zu öffnen, fordert eine Anwendung das entsprechende Objekt über die Schnittstelle an. Das ist besonders interessant für Webanwendungen, Medienbestände, Archive und Backups. Object Storage ist auf die Verwaltung großer Mengen unstrukturierter Daten ausgerichtet und lässt sich für solche Aufgaben gut skalieren.
Weniger passend ist er als unmittelbarer Ersatz für einen Datenträger, auf dem eine klassische Datenbank ständig kleine Bereiche verändert. Dafür ist der blockorientierte Zugriff gewöhnlich besser geeignet. Die Stärke von Object Storage liegt eher darin, vollständige Inhalte über eine API abzulegen und wieder abzurufen.
Die Unterschiede auf einen Blick
| Merkmal | Block Storage | File Storage | Object Storage |
|---|---|---|---|
| Bereitgestellte Einheit | Adressierbare Speicherblöcke | Dateien und Verzeichnisse | Objekte mit Metadaten und Kennung |
| Sicht der Anwendung | Datenträger beziehungsweise Volume | Dateiablage mit Pfaden | Über eine API erreichbarer Datenbestand |
| Typische Aufgaben | Virtuelle Festplatten, Datenbanken | Netzlaufwerke, Dokumente, Projektordner | Medien, Backups, Archive |
| Zentraler Vorteil | Gezielte Zugriffe auf Datenbereiche | Vertraute Organisation und gemeinsamer Dateizugriff | Skalierbare, API-basierte Datenverwaltung |
Die Tabelle beschreibt die grundlegenden Zugriffskonzepte und typische Einsatzfelder – keine allgemeingültige Rangliste nach Geschwindigkeit oder Qualität.
Welche Speicherart ist die richtige?
Die Entscheidung beginnt bei der Anwendung: Erwartet sie einen Datenträger, einen Dateipfad oder eine Objektschnittstelle? Daraus ergibt sich oft schon die passende Richtung. Virtuelle Festplatten und Datenbanken sprechen häufig für Block Storage, gemeinsame Arbeitsverzeichnisse für File Storage und große Medien- oder Backupbestände für Object Storage.
In der Praxis ergänzen sich die drei Ansätze. Eine Infrastruktur kann Block Storage für ihre virtuellen Maschinen, File Storage für gemeinsam genutzte Dokumente und Object Storage für Backups verwenden. Es geht daher nicht darum, einen universellen Sieger zu finden, sondern den Speicherzugriff an die jeweilige Aufgabe anzupassen.
